Od zestawienia opraw w PDF do oferty, którą da się obronić.
Light Box, asystent AI do wycen dla dostawcy oświetlenia: czyta zestawienia opraw z przetargowych PDF-ów, proponuje odpowiedniki z katalogu ponad 35 000 produktów, uzasadniając każdy wybór, a zweryfikowany wynik zamienia w ofertę gotową do eksportu.
- Branża
- Dystrybucja oświetlenia / wyceny przetargowe
- Zakres
- Pełna budowa produktu AI (backend + aplikacja web)
- Rynek
- Irlandia
Do każdego przetargu na oświetlenie dołączone jest zestawienie opraw: PDF z listą wszystkich opraw potrzebnych w budynku, często podanych kodem produktu konkurencji. Kosztorysanci dostawcy czytają je wiersz po wierszu, szukają najbliższego odpowiednika we własnym asortymencie i muszą obronić ten wybór w ofercie. Zbudowaliśmy Light Box, żeby przejął czytanie i szukanie, a zespół mógł skupić się na decyzjach.
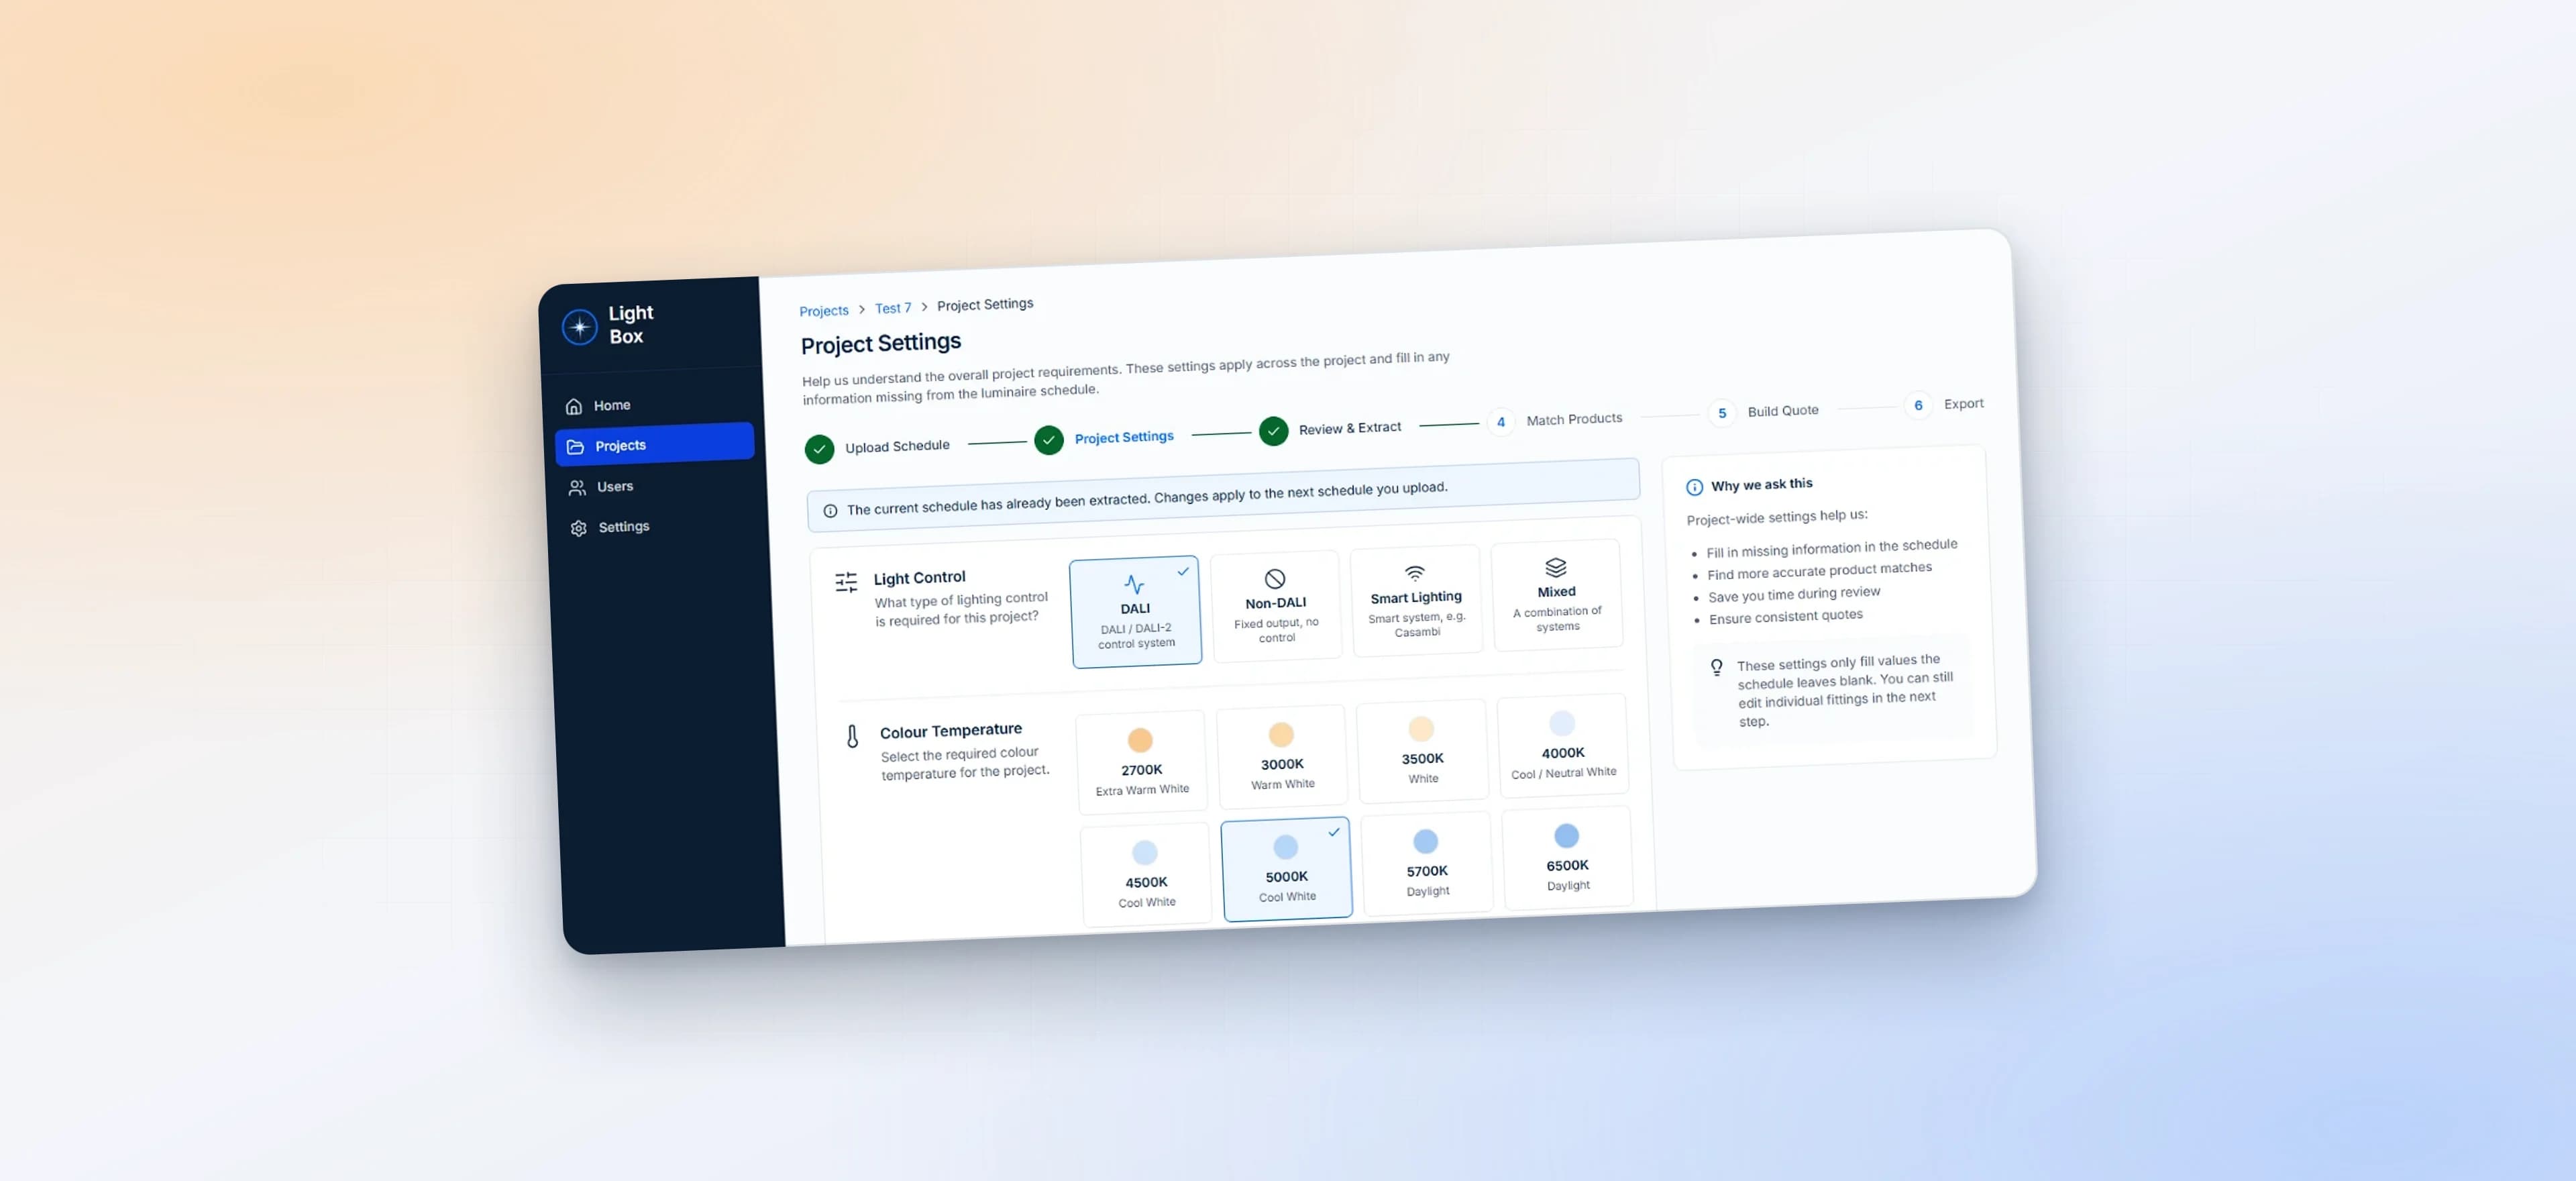
Light Box odczytuje zestawienie za pomocą AI i uzupełnia luki w sterowaniu, temperaturze barwowej i oświetleniu awaryjnym z ustawień projektu. Silnik regułowy, który wyjaśnia każdą decyzję, sprawdza każdy wiersz względem wspólnego katalogu dwóch europejskich producentów opraw, a zweryfikowany wynik trafia do oferty eksportowanej do Excela, CSV lub JSON. Automatycznie dopasowywane są tylko jednoznaczne wiersze; resztę dostaje człowiek razem z uzasadnieniem.
Z czym się mierzyliśmy
- Nie ma dwóch takich samych zestawień. Zestawienia przychodzą jako schludna trzystronicowa tabela, jako osobne bloki specyfikacji dla każdej oprawy rozłożone na jedenaście stron albo ukryte na dziesięciu stronach 141-stronicowej specyfikacji elektrycznej. Mają też własne błędy i luki: kody produktów rozbite na dwie linie, wiersze sprzeczne z własnym opisem, pozycje „TBC” i „by others”.
- Wiele wierszy wskazuje cudzy produkt. W realnych projektach, na których testowaliśmy system, co trzeci wiersz wskazywał oprawę konkurencji. Gdy zespół proponuje w jej miejsce odpowiednik z własnego asortymentu, musi umieć go uzasadnić, więc samo wyszukiwanie dokładnych kodów załatwia tylko część pracy.
- Dane produktowe w wielu formach. Obaj producenci różnie układają swój asortyment: od gotowych artykułów po tabele opcji i produkty konfigurowalne. Każdy producent, a także każde zestawienie, nazywa te same rzeczy inaczej.
- Idealny wynik może nic nie znaczyć. Produkt z brakującymi danymi niczemu nie przeczy, więc naiwny silnik ocenia go jako idealne dopasowanie. Równie kosztowne jest zawyżanie specyfikacji: moduł awaryjny czy zasilacz ściemnialny, których zestawienie wcale nie przewidywało, zmieniają i specyfikację, i cenę.
Jak to rozwiązaliśmy
- Odczyt AI według stałego schematu. Jedno ustrukturyzowane wywołanie AI czyta PDF z zestawieniem i zwraca odpowiedź w stałym schemacie wygenerowanym z modelu danych samego silnika dopasowań: 28 pól na wiersz, od kategorii i stopnia IP po temperaturę barwową, sterowanie i oświetlenie awaryjne. Odczyt i dopasowanie posługują się jednym słownikiem, a AI przytacza fragment źródłowy dla każdej wypełnionej wartości, zapisywany razem z surowym wynikiem ekstrakcji.
- Weryfikuje człowiek, a każda wartość ma etykietę. Kosztorysanci sprawdzają wyodrębnione wiersze, mając obok oryginalny PDF, edytują dowolną komórkę oraz dodają, duplikują lub usuwają wiersze. Każda wartość ma etykietę: odczytana z dokumentu, uzupełniona z ustawień projektu, wpisana ręcznie lub wciąż brakująca, a ustawienia projektu tylko wypełniają luki i nigdy nie nadpisują zestawienia.
- Silnik dopasowań, który wyjaśnia każdą decyzję. Każdy wiersz przechodzi przez dziewięć sprawdzeń w ustalonej kolejności, od dokładnego kodu produktu i nazwy serii po kategorię, dowody i rozstrzygnięcie, i kończy się jednym ze zdefiniowanych wyników z pełnym śladem decyzji. Oceny to zwykłe formuły na danych katalogowych, a nie opinia LLM. Poza przypadkami, gdy dokładny kod jednoznacznie wskazuje produkt, dopasowanie jest zatwierdzane automatycznie tylko wtedy, gdy pasuje do wiersza, dane katalogowe pozwalają na rzetelne porównanie, a sam produkt wyraźnie wygrywa z najlepszą alternatywą z innej serii; przy niemal równych wynikach system zadaje krótkie pytanie, zamiast zgadywać.
- Dwóch producentów, jeden katalog. Asortyment obu producentów połączyliśmy w jeden katalog ponad 35 000 produktów, opisanych jednym zestawem standardowych pól i przypisanych do 23 kategorii produktowych klienta. Wspólny słownik 163 aliasów tłumaczy nazewnictwo każdego producenta, a źródło każdej wartości jest zapisywane.
Mierzalny efekt
- O 80% szybsze przygotowanie oferty. Kosztorysanci nie przepisują już zestawień ani nie przeszukują ręcznie dwóch katalogów. Zaczynają od wyodrębnionych wierszy i uszeregowanych propozycji, a uwagę skupiają na pozycjach oznaczonych przez system.
- Propozycje, które zespół potrafi obronić. Przy każdej proponowanej oprawie widać, jakie sprawdzenia przeszła i dlaczego wygrała z alternatywami, więc ofertę można wyjaśnić projektantowi pozycja po pozycji.
- Bez cichego zawyżania specyfikacji. Gdy zestawienie czegoś nie precyzuje, silnik wybiera podstawowy wariant zamiast najbogaciej wyposażonego, dzięki czemu oferty trzymają się specyfikacji i pozostają konkurencyjne cenowo.
- Strojony na realnych projektach. Silnik jest strojony na benchmarku 20 realnych zestawień projektowych liczących łącznie 588 wierszy. W kolejnych rundach strojenia, wraz z dołączeniem katalogu drugiego producenta, liczba automatycznie zatwierdzonych odpowiedników na tym benchmarku wzrosła z 9 do 78.
Pod maską
- Ekstrakcja PDF trafia natywnie do Anthropic Claude ze structured output ograniczonym schematem, generowanym z modelu Pydantic wiersza silnika i zamkniętych enumów ze wspólnego rejestru pól; strażnik od razu zatrzymuje proces, gdy rejestr zawiera wartość, której prompt nie objaśnia. Workery w tle walidują plik przed płatnym wywołaniem, po przejściowych błędach ponawiają próby z backoffem i logują tokeny oraz szacowany koszt każdego uruchomienia.
- Dopasowanie Niezależna od domeny drabina dziewięciu polityk w ustalonej kolejności: wygrywa pierwsza decyzja końcowa, a każda ewaluacja jest logowana. Stopień dopasowania, pokrycie danych i porównywalność są liczone w kodzie, razem z marginesem przewagi nad najlepszą alternatywną rodziną produktów, a zgodność kodu produktu jest oceniana według poziomu pewności. Zestaw reguł jest wersjonowany, a jego wersja jest zapisywana przy każdej propozycji.
- Dane PostgreSQL 16 z wyszukiwaniem trigramowym. Adaptery dla poszczególnych producentów normalizują surowe rekordy do rejestru 31 pól i 23 kategorii klienta, zachowując pochodzenie każdej wartości i oryginalny rekord w JSONB.
- Backend Warstwowy serwis FastAPI na Pythonie 3.13 z handlerami komend i zapytań opartymi na Unit of Work, asynchroniczny SQLAlchemy na dwóch bazach PostgreSQL (aplikacja i katalog) i 20 migracji Alembic. Celery na Redisie uruchamia ekstrakcję i dopasowanie jako zadania w tle. Uwierzytelnianie JWT z rotacją refresh tokenów i haszowaniem argon2; oferty są strumieniowane jako XLSX, CSV lub JSON.
- Frontend Next.js 16 z React 19, Tailwind 4 i shadcn. Server Components równolegle pobierają dane z wyprzedzeniem i hydratują TanStack Query, a każde wywołanie API jest typowane z OpenAPI backendu. Proxy backend-for-frontend trzyma tokeny w ciasteczkach httpOnly, a edycja komórek w tabeli działa optymistycznie i przy błędzie wycofuje zmiany.
- Dostarczanie W CI działają ruff, mypy i 776 automatycznych testów backendu w pytest na prawdziwym PostgreSQL; pipeline frontendu uruchamia lint, typecheck i build produkcyjny. Kontenery Docker na AWS, wdrażane przez GitHub Actions, ze strukturalnymi logami JSON, identyfikatorami żądań przekazywanymi do zadań w tle, Sentry, OpenTelemetry i Prometheusem.
Czego użyliśmy
- AI
- Anthropic Claude
- Python
- FastAPI
- Next.js
- React
- TypeScript
- PostgreSQL
- SQLAlchemy
- Celery
- Redis
- TanStack Query
- Tailwind CSS
- OpenAPI
- Docker
- GitHub Actions
- AWS
- Sentry